이 코드는 어떤 문제를 푸나요?
CPU마다 일이 고르게 있지 않으면 어떤 CPU는 쉬는데 다른 CPU에는 실행 대기가 쌓일 수 있습니다. 그렇다고 아무 task나 가져올 수는 없습니다. CPU 허용 범위, 현재 실행 상태와 캐시 비용 등을 고려하여 이동 가능한 후보를 찾아야 합니다.
읽을 범위: v6.6 · kernel/sched/fair.c · detach_one_task 8799–8822행입니다. 아래에 이 범위의 원문과 각 줄의 설명을 실었습니다. 주제 전체의 흐름과 다른 경로는 기존 분석에서 함께 읽으실 수 있습니다.
먼저 알아둘 개념
src와 dst
src_rq는 작업을 가져올 원래 실행 큐이며 목적지는 lb_env가 담은 대상 CPU 정보로 결정됩니다. 주소 증가·감소와 관련된 방향이 아닙니다.
affinity
task가 실행되어도 되는 CPU 집합입니다. 목적 CPU가 허용 집합에 없다면 부하를 줄이려는 목적만으로 이동시킬 수 없습니다.
detach와 attach
원래 실행 큐에서 빼는 단계와 대상 실행 큐에 넣는 단계입니다. 이 둘을 구분해야 task가 이중으로 등록되거나 잠금 규칙이 꼬이는 문제를 이해할 수 있습니다.
처음 읽을 때
두 CPU에 각각 task 4개와 0개가 있다고 가정하세요. 네 개 중 세 개가 첫 CPU에 고정되어 있다면 숫자만 반으로 나누는 이동은 불가능합니다.
더 깊이 살펴볼 때
can_migrate_task의 판단과 detach_task가 변경하는 상태를 읽고 이후 attach 경로의 rq 잠금 순서를 비교하세요. 이 함수는 전체 load_balance의 한 단계입니다.
그림으로 보는 변화
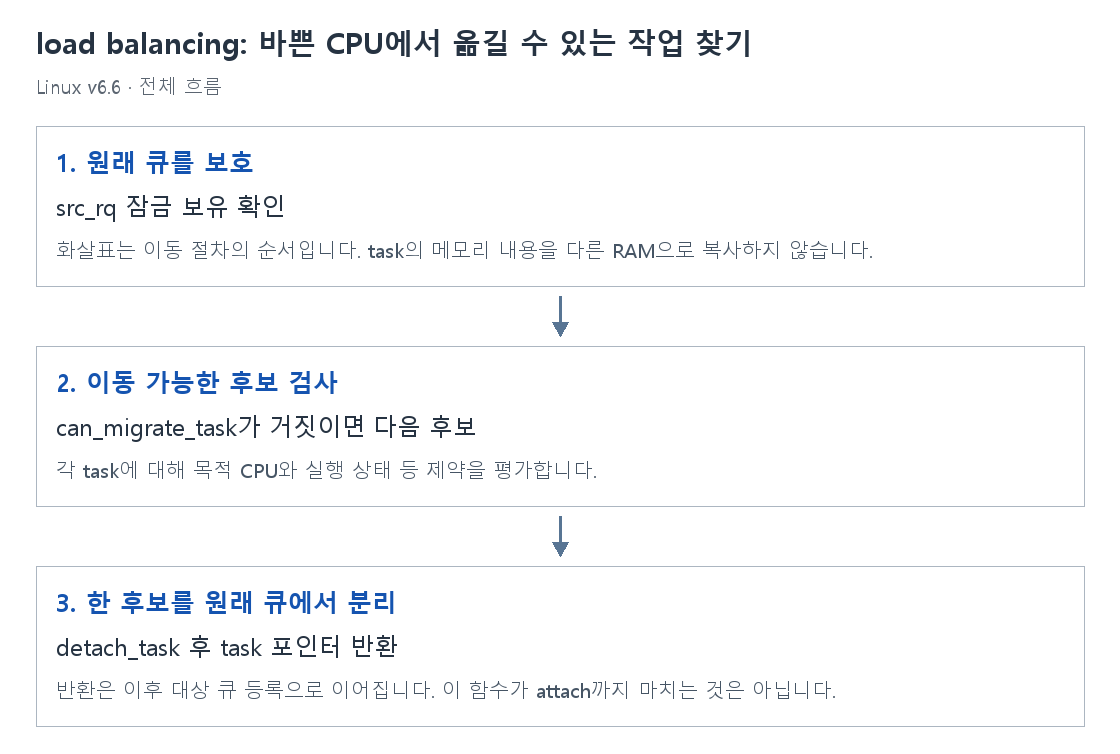
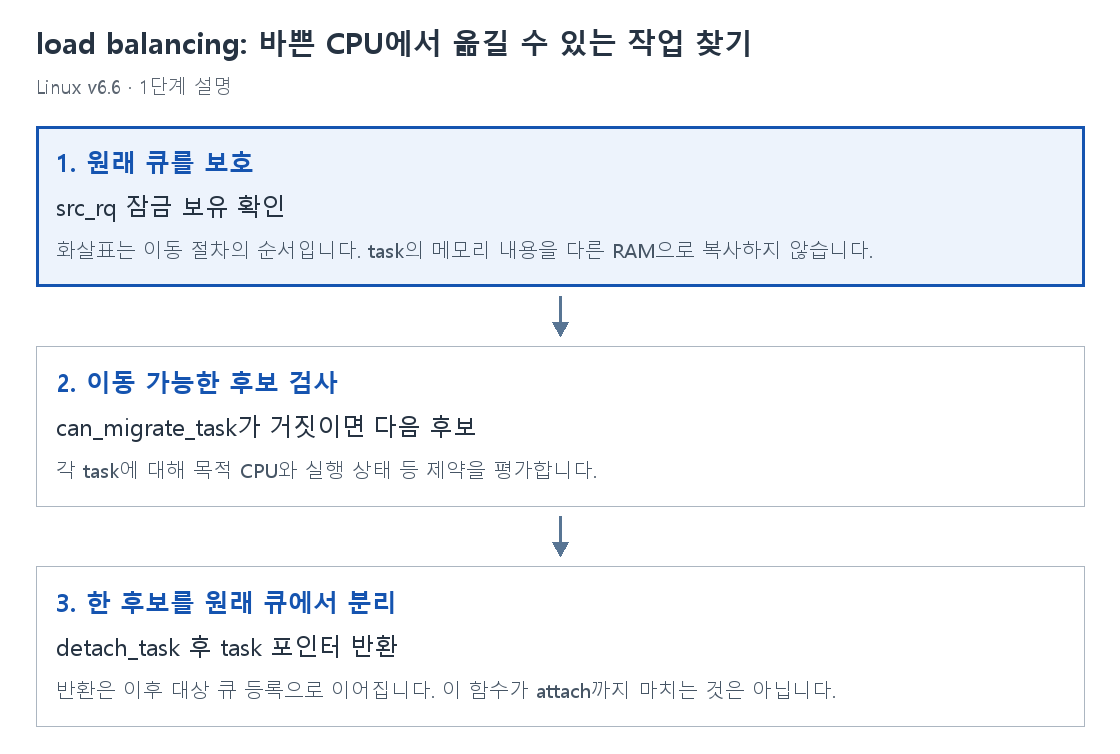
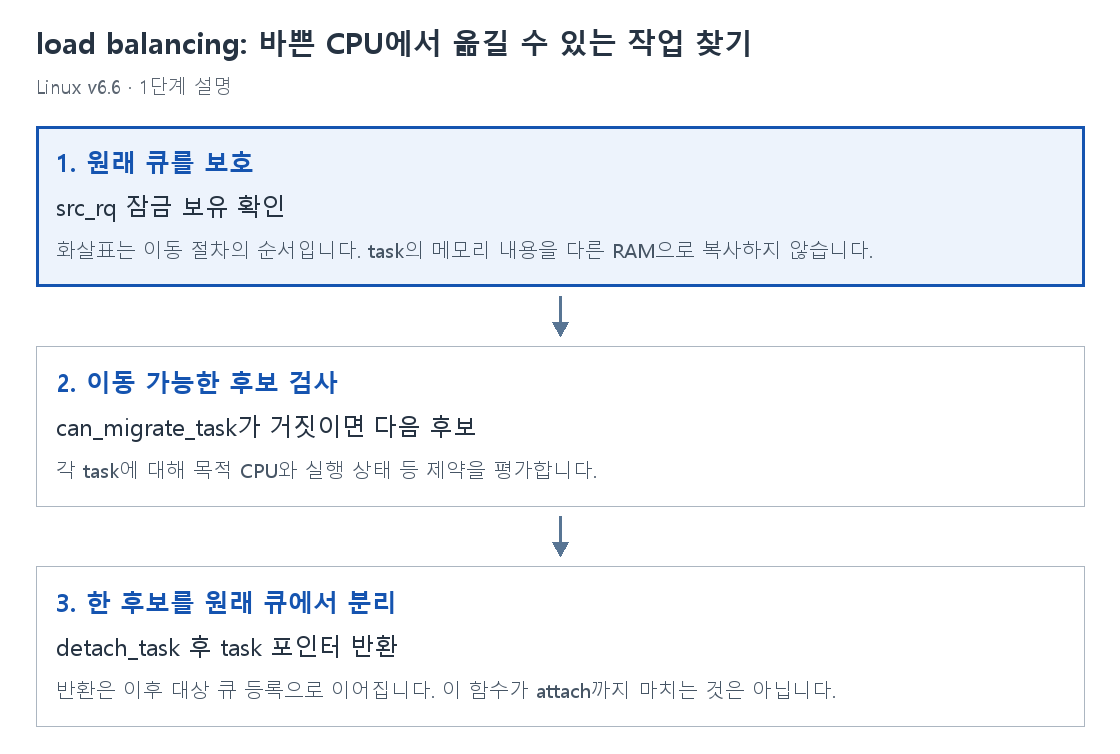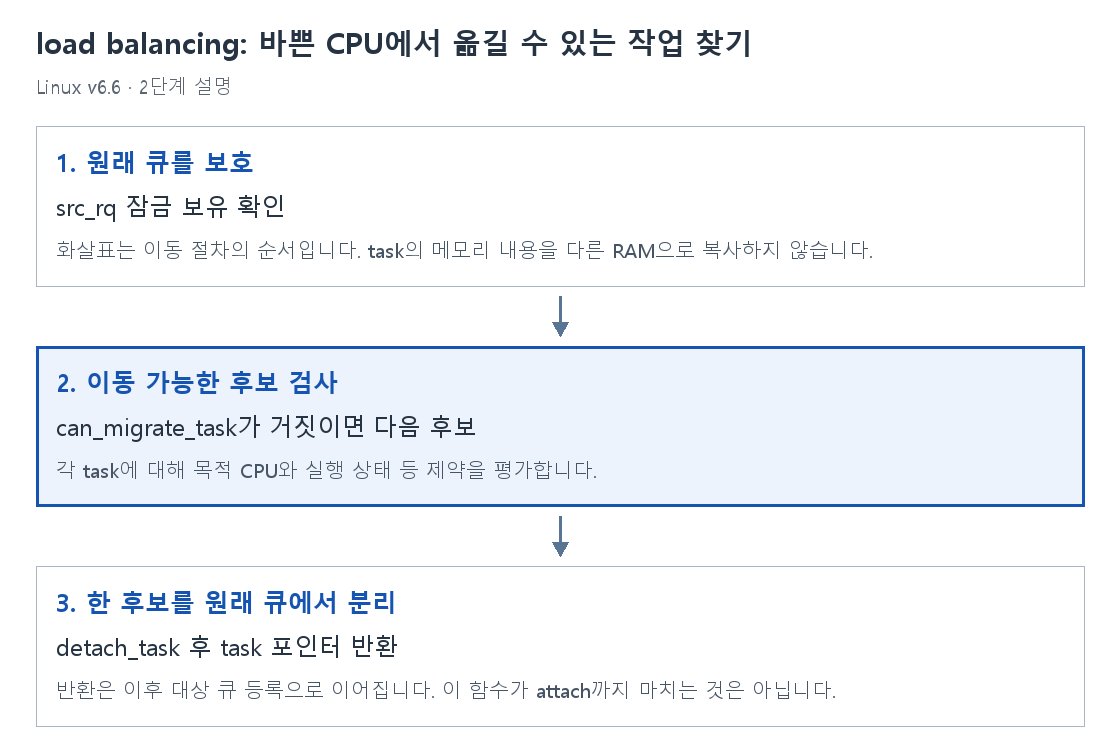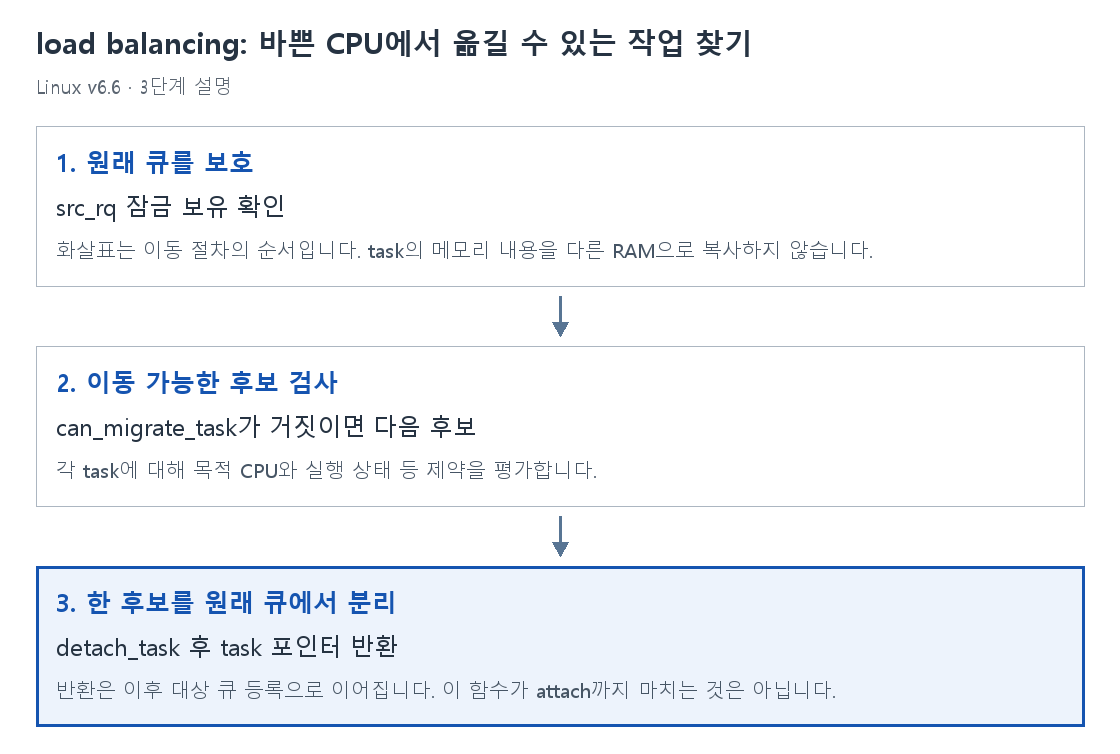
1. 원래 큐를 보호
src_rq 잠금 보유 확인
화살표는 이동 절차의 순서입니다. task의 메모리 내용을 다른 RAM으로 복사하지 않습니다.
2. 이동 가능한 후보 검사
can_migrate_task가 거짓이면 다음 후보
각 task에 대해 목적 CPU와 실행 상태 등 제약을 평가합니다.
3. 한 후보를 원래 큐에서 분리
detach_task 후 task 포인터 반환
반환은 이후 대상 큐 등록으로 이어집니다. 이 함수가 attach까지 마치는 것은 아닙니다.
detach_one_task를 한 줄씩 읽기
줄 번호는 v6.6 원문 기준입니다. 주석·빈 줄을 포함한 함수 전체를 먼저 보고, 그 아래에서 각 줄을 설명합니다.
static struct task_struct *detach_one_task(struct lb_env *env)
{
	struct task_struct *p;

	lockdep_assert_rq_held(env->src_rq);

	list_for_each_entry_reverse(p,
			&env->src_rq->cfs_tasks, se.group_node) {
		if (!can_migrate_task(p, env))
			continue;

		detach_task(p, env);

		/*
		 * Right now, this is only the second place where
		 * lb_gained[env->idle] is updated (other is detach_tasks)
		 * so we can safely collect stats here rather than
		 * inside detach_tasks().
		 */
		schedstat_inc(env->sd->lb_gained[env->idle]);
		return p;
	}
	return NULL;
}static struct task_struct *detach_one_task(struct lb_env *env)load balancing 환경에 맞는 task 하나를 원래 실행 큐에서 분리합니다. 여러 task를 한번에 옮기는 함수와 구분합니다.
struct task_struct *p;각 후보 task를 가리킬 포인터를 준비합니다.
lockdep_assert_rq_held(env->src_rq);호출자가 원래 rq 잠금을 잡고 있어야 한다는 조건을 lockdep으로 확인합니다. 여기서 잠금을 새로 획득하는 줄이 아닙니다.
list_for_each_entry_reverse(p,리스트를 뒤에서부터 순회하면서 task 구조체를 차례로 얻습니다. 매크로가 반복문을 구성합니다.
&env->src_rq->cfs_tasks, se.group_node) {src_rq의 cfs_tasks 목록에서 se.group_node 멤버를 연결 노드로 사용합니다. 반복 본문이 여기서 열립니다.
if (!can_migrate_task(p, env))이 후보를 현재 환경의 대상 CPU로 이동시킬 수 없는지 확인합니다. 판단 세부 사항은 can_migrate_task에 있습니다.
continue;불가능한 후보는 건드리지 않고 다음 task를 검사합니다.
detach_task(p, env);가능한 후보 하나를 원래 실행 큐에서 분리하고 이동 상태를 준비합니다. 이 시점에 대상 rq에 붙이는 호출은 아닙니다.
schedstat_inc(env->sd->lb_gained[env->idle]);현재 idle 분류에 맞는 부하 이동 성공 통계를 증가시킵니다. 정책 상태와 관찰용 통계를 구분해 보시면 됩니다.
return p;분리한 task를 반환합니다. 첫 성공에서 끝나므로 여러 task를 계속 옮기지 않습니다.
return NULL;이동 가능한 task를 찾지 못했으면 NULL을 반환합니다. 일상적으로 가능한 결과입니다.
함께 생각해 볼 질문
task 수만 같으면 부하도 같은가요?
아닙니다. 실행 요구량, CPU 용량, affinity와 캐시 관계 등도 다릅니다. 개수만으로 실제 실행 부담을 다 표현할 수 없습니다.
detach_one_task가 NULL을 반환하면 버그인가요?
아닙니다. 현재 조건을 만족하여 이동할 수 있는 후보가 없을 수 있습니다.
이동은 task_struct를 다른 메모리에 복사하는 것인가요?
여기서는 스케줄러의 소속 실행 큐와 CPU 관련 상태를 바꾸는 의미입니다. 구조체 바이트 전체를 복사하는 동작으로 읽지 않습니다.
출처와 읽은 범위
Linux stable v6.6 · kernel/sched/fair.c
해당 버전 원본 파일 · 기존 코드 분석 · 설명 원고